J’ai testé une base documentaire locale sur un MacBook
Une information peut être présente dans vos documents sans être facile à retrouver. Voici ce que mon test sur MacBook a montré, sans code ni commande.
Une réponse existe déjà dans vos documents. Elle est écrite quelque part, dans un fichier que personne ne rouvre par réflexe. J’ai voulu vérifier si une base documentaire locale sans code pouvait rendre cette information accessible, sur un test volontairement réduit : trois fichiers, deux questions, un MacBook.
Sommaire :
Le point de départ : quelques documents, une question précise
J’ai pris trois fichiers texte de spécifications, le genre de documents qu’une équipe consulte régulièrement sans jamais les avoir tous en tête. L’idée de discuter avec mes documents plutôt que de les rouvrir un par un est simple à formuler. Elle est plus difficile à vérifier honnêtement : une réponse bien écrite n’est pas forcément une réponse juste.
J’ai donc préparé deux questions. Pour la première, je connaissais le fichier et le passage exacts où figurait la réponse, ce qui me permettait de la contrôler : « À partir des documents de l’espace, dis-moi quel est le langage prévu pour le worker du projet (livrable 2) ? ». Pour la seconde, l’information demandée n’existait dans aucun des trois documents : « Vois-tu la description d’un module coach sportif dans les documents de l’espace ? ».
J’ai installé la dernière version stable d’AnythingLLM et suivi les réglages proposés par défaut à l’installation. L’application télécharge ses modèles au premier lancement, ce qui demande quelques minutes selon la connexion. Le reste de l’essai s’est fait dans l’interface, à la souris.
Le faux départ : mes documents n’étaient pas dans l’espace
J’ai d’abord chargé mes trois fichiers directement dans l’application. Je pensais que cela suffisait : les fichiers étaient visibles, donc disponibles pour répondre à mes questions. Ce n’était pas le cas. Je ne les avais pas attribués à l’espace de travail dans lequel je posais mes questions, et les réponses obtenues n’en tenaient pas compte.
Ce détail change la lecture d’un test raté. Avant de conclure qu’un outil répond mal, il faut vérifier sur quels fichiers il travaille réellement. Sans ce contrôle, on risque de changer de modèle ou d’abandonner l’idée, alors que le problème vient simplement de la place donnée aux documents.
Dans l’interface, le bouton de chargement des documents se trouve entre le nom de l’espace de travail et l’icône des paramètres, sans libellé visible. Il ouvre la gestion des fichiers : on y importe ses documents, on les sélectionne, puis on clique sur « Déplacer vers l’espace de travail » pour qu’ils deviennent réellement disponibles pour les questions posées dans cet espace.
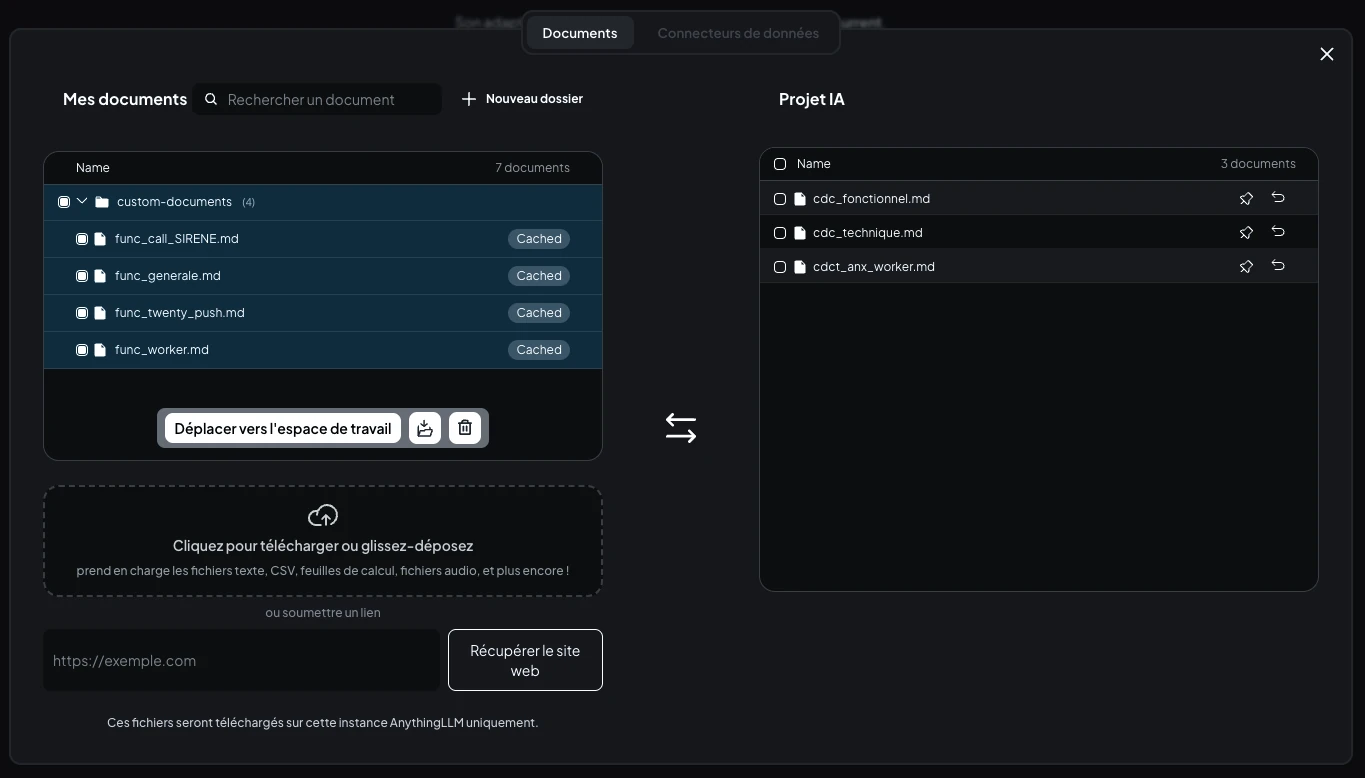
Un fichier joint à une conversation ne sert que cette conversation. Un document déplacé dans l’espace devient disponible pour toutes les questions posées dans cet espace. Sans cette distinction, on peut multiplier les essais sans jamais donner à l’outil ce dont il a besoin.
Vous ne savez pas ce que devient un document envoyé à une IA ?
10 minutes pour évaluer vos usages IA actuels.
Deux questions, puis la vérification dans les fichiers
Une fois les documents correctement déplacés dans l’espace, j’ai posé ma première question, celle dont je connaissais déjà la réponse. AnythingLLM a répondu que le worker du livrable 2 devait être développé en Go, ce qui correspondait bien au passage attendu.
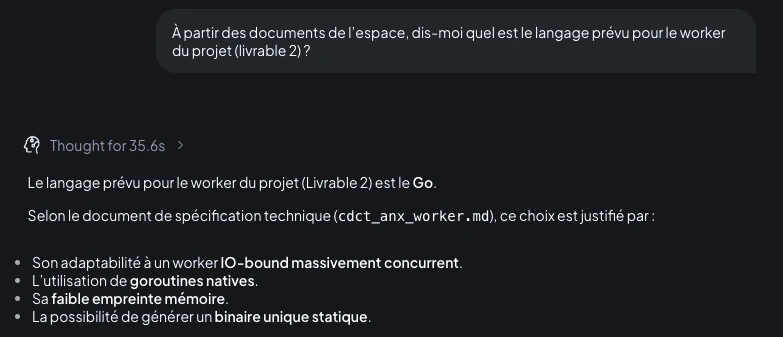
C’est ici que poser des questions à mes fichiers prend un sens concret. Le gain n’est pas une réponse plus rapide en soi. C’est la possibilité de retrouver une information tout en gardant le moyen de la vérifier. Sans ce contrôle, une réponse fluide ne dit rien de sa fiabilité.
Pour la seconde question, j’ai volontairement changé de réglage. J’ai utilisé @agent en combinant le mode agent avec le mode requête dans les paramètres du chat, pour forcer l’application à ne consulter que les documents de l’espace, sans compléter avec ses connaissances générales. AnythingLLM a alors indiqué qu’aucune description de module « coach sportif » n’existait dans les documents fournis, ce qui correspondait à la réalité : cette fonctionnalité n’a jamais été spécifiée.
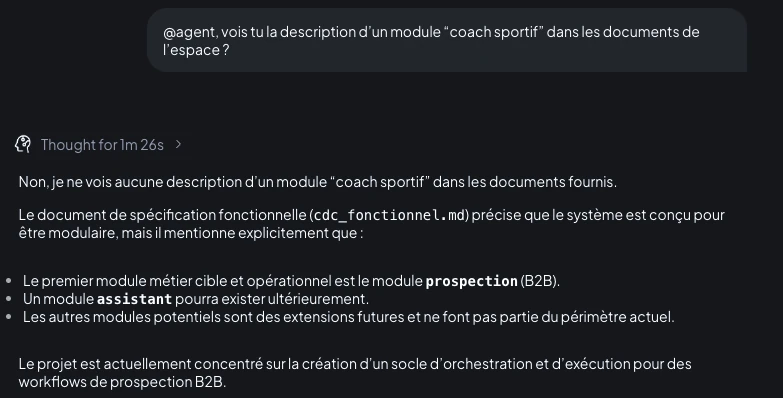
Ce réglage n’est pas un détail. Le mode chat mélange documents et connaissances générales du modèle, ce qui peut produire une réponse plausible même en l’absence d’information réelle. Le mode requête, lui, est conçu pour reconnaître l’absence de réponse plutôt que d’en inventer une. Tester une question sans réponse sans ce réglage aurait pu fournir un mauvais résultat (ce qui fut le cas sur un test précédent, l’IA a inventé un fichier pour pouvoir générer une réponse).
Sur ce test, le bilan est net : les deux réponses obtenues étaient conformes à ce qui était attendu, et l’information remontée provenait bien du bon fichier sources Le principe fonctionne, sur ce périmètre précis.
Ce qu’un test réussi ne règle pas encore
Trois fichiers dont je connais le contenu forment un cas facile à contrôler. Dans une entreprise, les documents se contredisent parfois, changent de version sans que tout le monde le sache et portent le même nom pour des contenus différents. L’application ne décide pas à la place de l’équipe quelle version fait référence.
Avant d’élargir l’usage, il reste à définir qui choisit les documents à inclure, qui retire les versions périmées et qui vérifie une réponse avant qu’elle serve de base à une décision. Réussir deux questions sur un échantillon réduit ne valide pas encore une base documentaire d’entreprise. Cela valide seulement que le principe fonctionne, sur ce périmètre-là.
Vous voulez savoir par où commencer sur vos propres documents ?
Un accompagnement adapté à votre taille, pas à une grande entreprise.
Pour aller plus loin, après le premier essai
Une fois ce fonctionnement compris, il devient possible de comparer d’autres modèles de réponse : qualité du français, respect des consignes, adéquation aux capacités de la machine. AnythingLLM permet de choisir un modèle différent, y compris pour un espace de travail particulier.
Ce modèle peut fonctionner sur le même ordinateur ou sur une autre machine du réseau local, à condition que le service choisi propose une interface compatible avec les standards que l’application reconnaît. Cela évite de faire tourner le modèle de réponse sur chaque poste utilisateur, mais suppose une machine dimensionnée pour cet usage. C’est un autre test, pas une étape nécessaire pour reproduire celui-ci. Cela ouvre en revanche l’utilisation du logiciel à des postes bureautique qui n’ont pas la puissance de faire tourner des IA localement.
Un point mérite d’être précisé avant de changer quoi que ce soit : le modèle qui rédige la réponse et celui qui prépare la recherche dans les documents jouent des rôles différents. Installer un modèle plus à l’aise en français ne garantit pas qu’il recevra le bon passage de la bonne spécification. Il faut reprendre les tests de validation après chaque changement, plutôt que de juger sur la seule qualité d’écriture de la réponse.
Retrouver l’information avant d’élargir l’usage
Sur ce test, les deux réponses obtenues étaient exactes. Le principe de la base documentaire locale tient, à condition de vérifier où sont réellement les fichiers et quel mode de conversation on utilise pour les interroger.
AnythingLLM propose par ailleurs un assistant de réunion, capable de transcrire un enregistrement et d’en produire un résumé. Après avoir personnalisé la consigne, j’ai obtenu une synthèse en français conforme à la réunion. Le moteur de transcription utilisé n’est en revanche pas celui qui donne les meilleurs résultats sur ma machine. AnythingLLM ne permet actuellement pas d’en choisir d’autre, donc si les réunions deviennent le besoin principal, cela justifie de tester aussi des outils spécialisés comme Meetily ou Meeting Transcriber, plutôt que de supposer qu’une seule application convient à tous les usages.